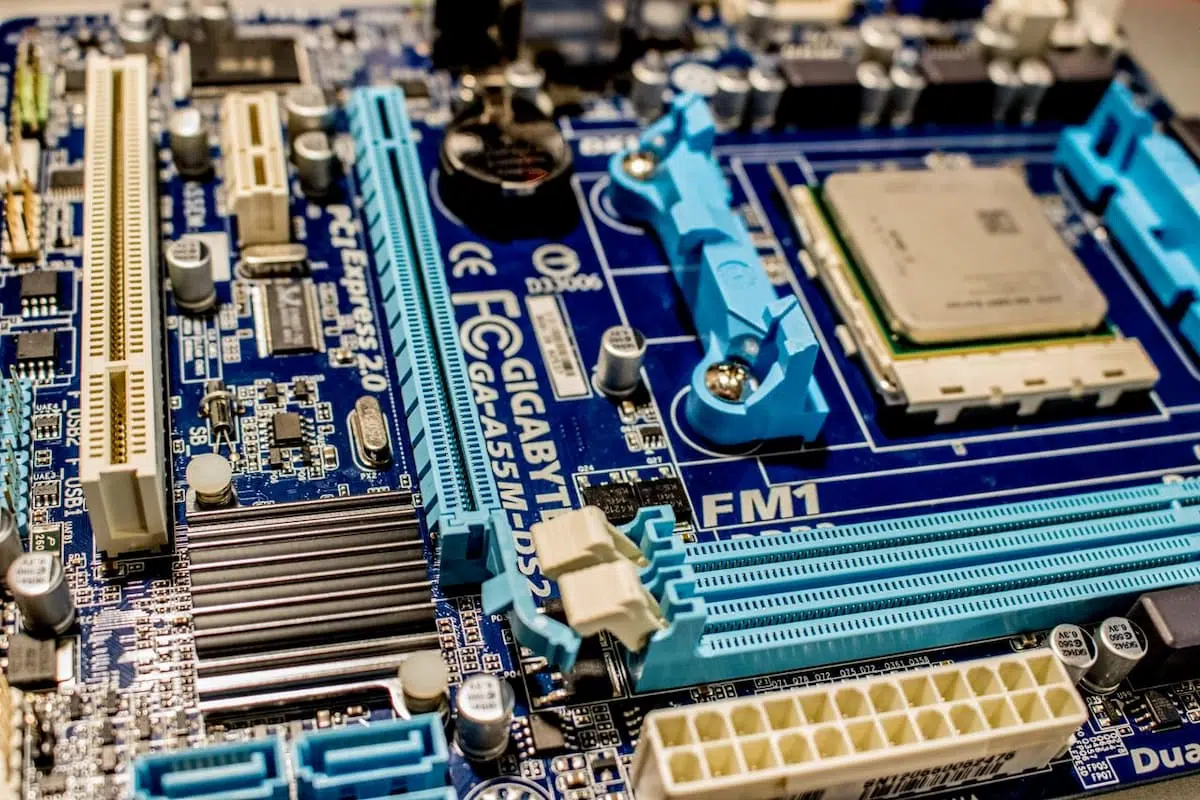
برقّل — عندما ترى في مواصفات جهاز عبارة مثل 8 Cores / 16 Threads أو 5.2GHz Turbo أو 24MB Cache، فأنت لا ترى «سرعة المعالج» كاملة، بل أجزاء من قصة أكبر بكثير. المعالج الحديث ليس مجرد قطعة صغيرة تنفذ الأوامر بسرعة؛ إنه نظام هندسي معقد يجمع أنوية متعددة، وذاكرة مخبئية، ووحدات تنبؤ وتنفيذ، ومتحكمات للطاقة والذاكرة، وأحياناً GPU وNPU ووحدات تشفير ومعالجة فيديو داخل شريحة واحدة.
ولهذا فإن فهم معالجات الكمبيوتر يحتاج إلى التمييز بين عدة طبقات:
- الترانزستور: المفتاح الإلكتروني الذي يبني الدوائر المنطقية.
- الـ ISA: مجموعة التعليمات التي يفهمها المعالج، مثل x86-64 وARM64.
- المعمارية الدقيقة: الطريقة الداخلية التي تنفذ بها الشريحة تلك التعليمات.
- التصميم الفيزيائي: عدد الشرائح، وتقنية التصنيع، والتغليف، والطاقة، والتبريد.
- النظام الكامل: الذاكرة، ونظام التشغيل، والبرامج، والرسوميات، والشبكة، والمسرعات المتخصصة.
هذا الدليل يشرح هذه الطبقات من الأساسيات إلى الاتجاهات الحديثة، ثم يحولها إلى طريقة عملية لفهم معالج مناسب للابتوب أو الكمبيوتر المكتبي أو الألعاب أو البرمجة أو التصميم أو الذكاء الاصطناعي.
الخلاصة السريعة قبل التفاصيل
- ارتفاع التردد لا يعني وحده أن المعالج أسرع. يجب النظر إلى IPC، والجيل، وعدد الأنوية، والكاش، وحدود الطاقة والتبريد.
- عدد الأنوية ليس مقياساً كاملاً. أربع أنوية قوية قد تتفوق على ثماني أنوية ضعيفة في بعض المهام.
- المعالج الحديث أصبح نظاماً على شريحة SoC في كثير من الأجهزة، ويضم CPU وGPU وNPU ووسائط واتصال وذاكرة مشتركة أو متكاملة.
- التصميم الهجين يضع أنوية أداء وأنوية كفاءة في الشريحة نفسها لتقديم استجابة عالية مع استهلاك أقل.
- Chiplets والتغليف المتقدم يسمحان ببناء معالج كبير من شرائح صغيرة متخصصة بدلاً من قالب واحد ضخم.
- المقارنة الصحيحة تكون حسب المهمة. معالج ممتاز للألعاب قد لا يكون الأفضل لعرض الفيديو أو تشغيل نماذج الذكاء الاصطناعي محلياً.
- في اللابتوب، حدود الطاقة والتبريد قد تكون أهم من اسم المعالج. المعالج نفسه قد يقدم أداءً مختلفاً في جهازين مختلفين.
ما هو المعالج CPU؟
CPU اختصار لـ Central Processing Unit، أي وحدة المعالجة المركزية. وظيفته الأساسية تنفيذ تعليمات البرامج: قراءة البيانات، إجراء الحسابات، اتخاذ قرارات منطقية، تحريك البيانات بين الذاكرة والتخزين، والتنسيق مع بقية مكونات الجهاز.
عند فتح متصفح أو تحرير صورة أو تشغيل لعبة، لا «يفهم» المعالج المهمة كما يفهمها الإنسان. البرنامج يحول المهمة إلى سلسلة من التعليمات الثنائية أو التعليمات الوسيطة، ثم يقرأ المعالج هذه التعليمات ويحللها وينفذها ويكتب النتائج.
لكن هذا الوصف مبسط. فالمعالج لا ينفذ دائماً تعليمة واحدة ثم ينتظر التالية. المعالجات الحديثة تحاول العمل على عدة تعليمات في الوقت نفسه، وتتوقع الفروع المقبلة، وتعيد ترتيب العمل داخلياً، وتحتفظ بالبيانات المتكررة داخل Cache قريبة من الأنوية. لذلك قد ينفذ معالج بتردد أقل أعمالاً أكثر من معالج قديم بتردد أعلى.
CPU مقابل GPU مقابل NPU
- CPU: معالج عام مرن، ممتاز للقرارات المعقدة والمهام المتنوعة وتشغيل نظام التشغيل.
- GPU: معالج متوازٍ يحتوي وحدات كثيرة لتنفيذ عمليات متشابهة على بيانات ضخمة، مثل الرسوميات والمصفوفات.
- NPU: وحدة متخصصة في عمليات الذكاء الاصطناعي والتعلم الآلي بكفاءة طاقة عالية.
في الكمبيوتر الحديث لا يعني وجود GPU أو NPU أن CPU لم يعد مهماً. بل يعمل كل مكوّن في المهمة التي يناسبها، ويتبادل الجميع البيانات عبر الذاكرة والناقلات.
كيف يعمل المعالج؟ دورة جلب التعليمة وتنفيذها
تعتمد الصورة التقليدية لعمل CPU على دورة متكررة تسمى غالباً Fetch–Decode–Execute:
- Fetch — الجلب: يجلب المعالج التعليمة من Cache أو الذاكرة.
- Decode — فك الترميز: يحلل نوع التعليمة والبيانات التي تحتاجها.
- Execute — التنفيذ: تنفذ وحدة الحساب أو المنطق العملية المطلوبة.
- Memory — الوصول للذاكرة: تقرأ أو تكتب بيانات عند الحاجة.
- Write-back — كتابة النتيجة: تحفظ النتيجة في سجل أو Cache أو الذاكرة.
المعالج الفعلي يقسم هذه العملية إلى مراحل كثيرة داخل Pipeline. وبينما تنفذ وحدة مرحلة من تعليمة، يمكن لوحدة أخرى جلب التعليمة التالية. يشبه ذلك خط إنتاج، لكن معقد للغاية ويحتوي على آليات للتعامل مع الفروع، والاعتماد بين التعليمات، وتأخر الذاكرة.
ما هو Pipeline؟
Pipeline هو تقسيم تنفيذ التعليمة إلى مراحل متتابعة. كلما كان الخط منظماً، يمكن للمعالج أن يبدأ تعليمات جديدة قبل انتهاء التعليمات السابقة. لكن زيادة عمق الخط ليست حلاً سحرياً؛ فإذا أخطأ المعالج في توقع فرع، فقد يضطر إلى تفريغ مراحل كثيرة وإعادة ملئها، وهو ما يسمى Pipeline Flush.
التنفيذ خارج الترتيب Out-of-Order
البرامج تكتب التعليمات بترتيب معين، لكن بعض التعليمات قد تنتظر بيانات أو وحدة تنفيذ. المعالج الذكي يستطيع تنفيذ تعليمات مستقلة لاحقة قبل التعليمة المنتظرة، ثم يعيد ترتيب النتائج داخلياً حتى يراها البرنامج بالترتيب الصحيح.
هذه التقنية تسمى Out-of-Order Execution، وهي من أسباب ارتفاع الأداء الحقيقي مقارنة بتردد المعالج النظري. لكنها تحتاج إلى دوائر معقدة لتتبع الاعتماد بين التعليمات، وحجز النتائج، وإعادة ترتيبها.
التنفيذ الاستباقي Speculative Execution
عندما يصل البرنامج إلى شرط مثل if، لا يعرف المعالج دائماً أي فرع سيحدث. بدلاً من التوقف، يتوقع المسار الأكثر احتمالاً ويبدأ العمل عليه. إذا كان التوقع صحيحاً، يوفر وقتاً. وإذا كان خاطئاً، يلغي العمل المتوقع ويبدأ المسار الصحيح.
تحتاج هذه التقنية إلى حماية أمنية؛ فقد أظهرت ثغرات مثل Spectre وMeltdown أن بعض الآثار الجانبية للتنفيذ الاستباقي يمكن استغلالها لاستخراج معلومات من الذاكرة. لذلك تطورت أنظمة التشغيل والمعالجات والتعريفات لإضافة وسائل تخفيف، وقد يكون لبعضها أثر أداء في حالات معينة.
التنبؤ بالفروع Branch Prediction
Branch Predictor وحدة تتوقع نتيجة الفروع الشرطية ومكان التعليمة التالية. كلما تحسن التنبؤ، قل عدد مرات تفريغ Pipeline. وهي من أكثر الأجزاء تأثيراً في أداء البرامج التي تحتوي على قرارات كثيرة أو تعليمات غير منتظمة.
الترانزستورات: اللبنات التي صنعت تطور المعالجات
الترانزستور مفتاح إلكتروني بالغ الصغر يمكن أن يمثل حالات منطقية مثل 0 و1. تجمع الدوائر ملايين أو مليارات الترانزستورات لبناء:
- بوابات منطقية.
- سجلات تحفظ قيماً صغيرة.
- وحدات جمع وضرب ومنطق.
- وحدات تنبؤ وفك ترميز.
- Cache وذاكرات مؤقتة.
- متحكمات طاقة وذاكرة واتصال.
كلما أمكن وضع ترانزستورات أكثر في مساحة معقولة، أصبح من الممكن إضافة أنوية أو Cache أو وحدات متخصصة، أو تقليل الطاقة اللازمة للمهمة نفسها. لكن «رقم النانومتر» لم يعد مقارنة بسيطة بين شركتين؛ فتعريفات أبعاد الترانزستور وتقنيات التصنيع تختلف، والأداء النهائي يعتمد على التصميم والتغليف والطاقة وليس على الرقم وحده.
لماذا لم يعد قانون مور كافياً وحده؟
ينسب إلى قانون مور توقع زيادة كثافة الترانزستورات مع الزمن. ساعد هذا الاتجاه الصناعة لعقود، لكن تصغير الترانزستور أصبح أصعب وأغلى، وظهرت حدود الحرارة والتسرب والطاقة. لذلك لم يعد التطور يعتمد على التصغير فقط، بل على:
- تحسين المعمارية الدقيقة ورفع IPC.
- إضافة أنوية أكثر أو أنوية مختلفة.
- تكبير Cache وتقريبها من الأنوية.
- استخدام Chiplets بدلاً من قالب واحد.
- التكديس ثلاثي الأبعاد للذاكرة أو Cache.
- دمج CPU وGPU وNPU داخل SoC.
- تحسين إدارة الطاقة والتردد.
- بناء وحدات متخصصة للصوت والفيديو والتشفير والذكاء الاصطناعي.
ISA أم Microarchitecture؟ الفرق الذي يفسر اختلاف Intel وAMD وArm
ما هي ISA؟
ISA اختصار لـ Instruction Set Architecture، وهي العقد بين البرمجيات والمعالج. تحدد ISA التعليمات والسجلات وأنواع البيانات وطريقة التعامل مع الذاكرة وبعض قواعد التنفيذ.
أمثلة مشهورة:
- x86-64: تستخدمها معالجات Intel وAMD في كثير من أجهزة الكمبيوتر.
- ARM64 / AArch64: تستخدمها شرائح Arm في الهواتف وأجهزة Apple Silicon وأجهزة أخرى.
- RISC-V: ISA مفتوحة المصدر نسبياً يمكن للشركات والمؤسسات بناء معالجات حولها.
إذا كان البرنامج مبنياً لمعمارية معينة، فقد يحتاج إلى ترجمة أو طبقة توافق كي يعمل على ISA مختلفة. مع ذلك، لا تكفي معرفة ISA لتحديد الأداء.
ما هي المعمارية الدقيقة؟
Microarchitecture هي التصميم الداخلي الذي ينفذ ISA. يمكن لشريحتين أن تدعما ISA نفسها، لكن تختلفان جذرياً في:
- عدد مراحل Pipeline.
- عرض فك التعليمات.
- حجم ونظام Cache.
- عدد وحدات التنفيذ.
- جودة التنبؤ بالفروع.
- قدرة التنفيذ خارج الترتيب.
- وحدات SIMD والمتجهات.
- إدارة الطاقة والتردد.
لهذا لا يصح القول إن كل معالجات x86 متساوية، أو أن كل معالجات Arm متساوية. ISA تحدد «ما الذي يفهمه المعالج»، بينما المعمارية الدقيقة تحدد «كيف ينفذه وبأي كفاءة».
هل RISC أسرع من CISC؟
الاختصاران تاريخيان:
RISCيركز على مجموعة تعليمات أبسط وأكثر انتظاماً.CISCيسمح بتعليمات أكثر تعقيداً وتاريخاً أطول من التوافق.
لكن المعالجات الحديثة لا تتطابق مع الصور القديمة. معالج x86 قد يحول التعليمات المعقدة إلى عمليات داخلية صغيرة، ومعالج RISC حديث قد يحتوي على تصميم Out-of-Order عميق ومعقد. الأداء لا يحدد من اسم RISC أو CISC وحده، بل من التنفيذ الفعلي والتصميم والبرامج والطاقة.
السجلات ووحدات التنفيذ وALU وFPU
Registers — السجلات
السجلات ذاكرة صغيرة جداً داخل النواة. تستخدم لحفظ البيانات والعناوين والنتائج التي تحتاجها التعليمات فوراً. الوصول إليها أسرع من Cache، لكن عددها وسعتها محددان.
ALU — وحدة الحساب والمنطق
ALU تنفذ العمليات الصحيحة والمنطقية مثل الجمع والطرح والمقارنة وعمليات AND وOR وXOR.
FPU — وحدة الفاصلة العائمة
FPU تنفذ حسابات الأرقام العشرية أو ذات الفاصلة العائمة، المهمة في المحاكاة والهندسة والرسوميات والعلوم.
Vector وSIMD
SIMD تعني تنفيذ تعليمة واحدة على عدة عناصر بيانات في الوقت نفسه. بدلاً من جمع رقمين فقط، يمكن للتعليمة معالجة مجموعة أرقام في سجل متجهي. تستخدم هذه القدرات في الصور والفيديو والصوت والتشفير والحسابات العلمية.
من أمثلتها عائلات تعليمات مثل SSE وAVX في x86، وتعليمات NEON وSVE في Arm. لكن دعم التطبيق لهذه التعليمات وطريقة استخدامه لها مهمان؛ وجود الوحدة في المعالج لا يضمن تسارع كل برنامج.
وحدات التشفير
تحتوي معالجات حديثة على تعليمات أو وحدات لتسريع AES والتوقيعات والتجزئة وأعمال الأمان. هذا يقلل تكلفة التشفير في الأقراص والاتصالات والشبكات، لكن الأداء يعتمد أيضاً على نظام التشغيل والمكتبات.
الأنوية والخيوط: لماذا لا يكفي عدّها؟
Core — النواة
النواة وحدة تنفيذ مستقلة نسبياً داخل CPU. وجود ثماني أنوية يعني أن المعالج يستطيع معالجة عدة خيوط في وقت متزامن، لكن توزيع العمل يعتمد على البرنامج ونظام التشغيل.
Thread — الخيط
الخيط هو مسار تنفيذ داخل برنامج. يمكن لبرنامج واحد أن يملك خيطاً واحداً أو عشرات الخيوط. إذا كان البرنامج أحادي الخيط، فلن يستفيد بالضرورة من كل أنوية المعالج.
SMT وHyper-Threading
تسمح تقنية SMT للنواة الواحدة بتتبع أكثر من خيط، بحيث تستغل وحدات التنفيذ التي قد تكون عاطلة أثناء انتظار الذاكرة. لا تعني هذه التقنية أن نواتين فعليتين أصبحتا أربعاً؛ الزيادة تختلف حسب المهمة وقد تكون صغيرة أو كبيرة أو شبه معدومة.
الأداء أحادي الخيط ومتعدد الخيوط
- Single-thread performance: مهم لواجهة البرامج، وتصفح الويب، وبعض الألعاب، والمهام التي لا يمكن تقسيمها بسهولة.
- Multi-thread performance: مهم للترميز، وتجميع المشاريع، والرندر، والمحاكاة، وضغط الملفات، وتشغيل عدة مهام متزامنة.
المعالج الأفضل هو الذي يناسب نمط عملك، لا الذي يملك أكبر رقم مطبوع على العلبة.
التردد وIPC وTurbo: قراءة الأرقام بطريقة صحيحة
Clock Speed وGHz
التردد يقيس عدد دورات الساعة في الثانية. معالج 4GHz ينفذ أربع مليارات دورة تقريباً في الثانية، لكن الدورة ليست وحدة ثابتة من العمل بين معماريتين مختلفتين. قد تنفذ معمارية حديثة تعليمات أكثر في الدورة نفسها من معمارية أقدم.
IPC — Instructions Per Cycle
IPC هو عدد التعليمات التي يستطيع المعالج إنجازها في دورة تقريباً. الأداء النظري يتأثر بالتردد وIPC، لكن لا يوجد رقم واحد بسيط يصف كل البرامج، لأن التعليمات والذاكرة والتنبؤ والفروع تختلف.
صيغة تقريبية مفيدة:
الأداء التقريبي في المهام الملائمة = عدد الأنوية × التردد الفعلي × IPC × كفاءة الاستفادة من الموارد.
هذه ليست معادلة معيارية لشراء المعالج، لكنها تشرح لماذا لا يكفي مقارنة GHz.
Base Frequency
التردد الأساسي هو نقطة تشغيل مرجعية ضمن شروط الطاقة والحرارة المحددة. لا يعني أن المعالج سيعمل دائماً عليه، ولا يعني أنه أقل أداءً في كل مهمة.
Turbo أو Boost Frequency
التردد المعزز سرعة أعلى يصل إليها المعالج لفترة عندما تسمح الحرارة والطاقة وعدد الأنوية النشطة. قد يصل الرقم إلى قيمة مرتفعة على نواة أو عدد قليل من الأنوية، بينما تكون السرعة المستمرة على جميع الأنوية أقل.
يوضح Intel أن Turbo يتأثر بعدد الأنوية المستخدمة وقدرة التبريد والطاقة المتاحة، لذلك لا ينبغي قراءة رقم Turbo كأنه سرعة ثابتة لكل الأحمال [1].
TDP وPBP وPPT وPL1 وPL2
الأسماء تختلف بين الشركات، لكن الفكرة واحدة: المعالج يعمل ضمن ميزانية حرارية وطاقية:
TDPمؤشر تصميم حراري/طاقي يساعد في تصميم التبريد، وليس بالضرورة الحد الأقصى للاستهلاك.PL1وPL2في بعض معالجات Intel يصفان حدود طاقة طويلة وقصيرة المدى.PPTفي بعض منصات AMD يصف سقفاً لحزمة الطاقة.- قد تضع الشركة المصنعة للابتوب حدوداً أقل أو أعلى من القيم النظرية للمعالج.
لذلك قد يقدم المعالج نفسه أداءً مختلفاً في لابتوب نحيف صامت وفي لابتوب سميك بتبريد قوي. ولمعرفة كيف يؤثر التبريد الفعلي على الأداء في جهازك، راجع دليل لماذا يسخن اللابتوب وكيف تحل المشكلة.
Cache: الذاكرة التي تقرب البيانات من النواة
الذاكرة الرئيسية RAM أبطأ بكثير من النواة. لو انتظر المعالج RAM في كل تعليمة، لبقيت وحدات التنفيذ عاطلة معظم الوقت. لذلك توجد طبقات Cache صغيرة وسريعة:
- L1 Cache: الأسرع والأقرب والأصغر، وغالباً مقسمة إلى Cache للتعليمات والبيانات.
- L2 Cache: أكبر وأبطأ قليلاً، وقد تكون خاصة بكل نواة.
- L3 Cache: أكبر غالباً ومشتركة بين مجموعة أنوية أو القالب كله.
- L4 Cache: نادرة أو خاصة بتصميمات معينة.
Cache Hit وCache Miss
- Cache Hit: البيانات موجودة في الطبقة المطلوبة، فيتم الوصول إليها بسرعة.
- Cache Miss: البيانات غير موجودة، فيبحث المعالج في طبقة أبطأ أو في RAM.
لا تعني Cache الأكبر دائماً أداءً أعلى. يعتمد الأثر على طبيعة البرنامج، وحجم البيانات، وتصميم الذاكرة، وزمن الوصول، وطريقة مشاركة Cache بين الأنوية.
لماذا تفيد Cache الكبيرة في الألعاب؟
الألعاب قد تعيد استخدام بيانات صغيرة نسبياً مرتبطة بمحرك اللعبة والذكاء الاصطناعي والفيزياء. إبقاء هذه البيانات قريبة من الأنوية يقلل رحلات الوصول إلى RAM، ولذلك قد تحقق معالجات ذات Cache إضافية تحسناً في بعض الألعاب دون زيادة كبيرة في التردد.
3D V-Cache والتكديس العمودي
التكديس ثلاثي الأبعاد يضع طبقة Cache فوق قالب المعالج أو بجانبه عبر وصلات كثيفة. هدفه زيادة السعة وتقليل المسافة، لكن التكديس يفرض تحديات في الحرارة والتصنيع والتكلفة والتوافق. تستخدم AMD تقنية 3D V-Cache مثالاً على إضافة Cache مكدسة لتحسين بعض أحمال الألعاب والحوسبة [2].
من النواة الواحدة إلى المعالجات متعددة الأنوية
كان رفع التردد أسهل طريقة ظاهرة لزيادة الأداء، لكن الحرارة واستهلاك الطاقة جعلا الاستمرار في رفع التردد أصعب. تحولت الصناعة إلى إضافة أنوية وتحسين كفاءة كل نواة.
قانون التوسع المتوازي
إذا أمكن تقسيم مهمة إلى أجزاء مستقلة، تستطيع عدة أنوية تنفيذها في وقت واحد. لكن جزءاً من البرنامج قد يبقى متسلسلاً، كما أن تقسيم المهمة وإعادة جمع النتائج له تكلفة. لهذا لا يتضاعف الأداء تماماً عند مضاعفة عدد الأنوية.
Amdahl’s Law بشكل مبسط
إذا كان 20% من المهمة لا يمكن تسريعه بالتوازي، فستصل إلى حد لا يفيد بعده إضافة عدد لا نهائي من الأنوية. لذلك يجب أن يكون البرنامج مصمماً للتوازي، وأن تكون الذاكرة والنقل والتخزين قادرة على تغذية الأنوية.
NUMA والأنظمة الكبيرة
في الخوادم ومحطات العمل، قد تختلف مسافة بعض الأنوية عن بعض الذاكرة. هذا يسمى NUMA، ويجعل مكان البيانات وجدولة الخيوط مؤثرين في الأداء. أما معظم أجهزة المستهلك فتستخدم نموذجاً أبسط، لكن آثار الكاش والذاكرة والمجموعات لا تختفي تماماً.
التصميم الهجين: P-cores وE-cores وbig.LITTLE
الفكرة الأساسية
بدلاً من جعل كل الأنوية متطابقة، تضع المعمارية الهجينة أنواعاً مختلفة:
- P-core أو Performance Core: نواة أكبر وأقوى، مناسبة للعمل التفاعلي والمهام الحساسة للزمن.
- E-core أو Efficiency Core: نواة أصغر وأكثر كفاءة، مناسبة للمهام الخلفية والعمل المتوازي الخفيف أو المستمر.
- LP E-core: نواة منخفضة الطاقة جداً في بعض التصاميم، للمهام الخفيفة عندما يكون الجهاز في وضع توفير الطاقة.
تستخدم Arm فكرة big.LITTLE بدمج أنوية عالية الأداء وأنوية عالية الكفاءة داخل SoC، مع توزيع المهام ديناميكياً بحسب الحمل [3]. كما تستخدم Intel في تصميمات هجينة حديثة P-cores وE-cores، ويقدم Thread Director معلومات للجدولة كي يختار نظام التشغيل النواة الأنسب للخيط [4].
لماذا التصميم الهجين مهم للابتوب؟
في اللابتوب، لا تحتاج كتابة بريد أو تشغيل موسيقى إلى نواة عالية الاستهلاك. يمكن وضع العمل الخلفي على E-cores وترك P-cores متاحة للاستجابة، أو إيقاف أجزاء من الشريحة لتقليل الطاقة. عند تشغيل تصيير أو لعبة، تنشط الأنوية الأقوى وتسمح ميزانية الطاقة والتبريد بذلك.
دور نظام التشغيل
لا يكفي وجود P-cores وE-cores. يجب أن يعرف نظام التشغيل نوع النواة والحمل وأولوية الخيط وحالة البطارية. جدولة خاطئة قد تضع مهمة حساسة على نواة غير مناسبة، أو تنقل الخيط كثيراً بين الأنوية فتخسر Cache ووقتاً في تبديل السياق.
هذا سبب أهمية تحديث Windows أو Linux والتعريفات وFirmware في الأجهزة الهجينة، خصوصاً في الإصدارات الأولى من أي تصميم جديد.
هل E-core نواة سيئة؟
لا. E-core مصممة لهدف مختلف. قد تكون أقل أداءً فردياً، لكنها توفر أداءً جيداً لكل واط، ويمكن جمع عدد كبير منها للمهام المتوازية. الخطأ هو مقارنة P-core وE-core كما لو كانا النوع نفسه.
Arm وApple وQualcomm
لم تبدأ فكرة الأنوية المختلفة مع Intel. استخدمت Arm بنية big.LITTLE منذ سنوات في الهواتف والأجهزة منخفضة الطاقة. كما تبني Apple Silicon مزيجاً من Performance Cores وEfficiency Cores داخل SoC، وتستخدم Qualcomm في Oryon فئات مثل Prime وPerformance لتوازن الاستجابة والكفاءة [3] [5] [6].
من CPU منفصل إلى SoC
ما هو SoC؟
SoC اختصار لـ System on a Chip، أي نظام على شريحة. بدلاً من وضع CPU في شريحة منفصلة وGPU ومتحكم الذاكرة ووسائط الاتصال في شرائح أخرى، يدمج SoC مكونات عديدة في حزمة أو قالب مترابط.
قد يتضمن SoC:
- CPU بأنوية أداء وكفاءة.
- GPU مدمجاً.
- NPU أو محرك AI.
- متحكم RAM.
- وحدات تشفير.
- محرك فيديو للترميز والفك.
- متحكم شاشة وصوت.
- Wi-Fi أو Bluetooth أو مودم في بعض المنصات.
- متحكمات USB وPCIe وتخزين.
مزايا SoC
- مسافات أقصر بين المكونات.
- استهلاك طاقة أقل في بعض الأحمال.
- تصميم أصغر وأنحف.
- مشاركة الذاكرة بين CPU وGPU وNPU.
- تقليل عدد الشرائح والاتصالات الخارجية.
- إمكانات أفضل لأجهزة اللابتوب الهادئة والخفيفة.
عيوب SoC
- ترقية RAM أو GPU قد تكون مستحيلة.
- إذا تعطلت وحدة رئيسية، قد تحتاج استبدال اللوحة أو الجهاز.
- مشاركة الذاكرة تعني أن GPU قد ينافس CPU على السعة والنطاق.
- التوافق مع البرامج القديمة قد يحتاج ترجمة أو طبقة توافق عند الانتقال بين ISA.
الذاكرة الموحدة Unified Memory
في التصميم التقليدي، يملك CPU RAM ويملك GPU المنفصل VRAM، وقد تُنسخ البيانات بينهما. في الذاكرة الموحدة توجد مساحة عالية النطاق يمكن لعدة وحدات داخل SoC الوصول إليها، ما يقلل النسخ في سيناريوهات معينة.
تشرح Apple أن Unified Memory Architecture تضع تجمعاً واحداً من الذاكرة يمكن لتقنيات الشريحة الوصول إليه، ما يقلل نسخ البيانات ويجمع بين عرض نطاق عالٍ وزمن وصول منخفض وكفاءة طاقة [6].
لكن الذاكرة الموحدة ليست «مجانية»: CPU وGPU وNPU يتشاركون السعة نفسها، وإذا امتلأت قد يعتمد النظام على التخزين الافتراضي البطيء. لذلك يجب اختيار سعة كافية من البداية في الأجهزة التي لا تسمح بترقية RAM.
Chiplets: لماذا تتكون المعالجات الحديثة من عدة شرائح؟
التصميم الأحادي Monolithic Die
في التصميم الأحادي، توجد معظم أنوية المعالج والمتحكمات داخل قالب سيليكون واحد. هذا قد يوفر اتصالاً سريعاً داخلياً، لكنه يصبح صعباً ومكلفاً عندما يكبر القالب، كما تنخفض نسبة القوالب السليمة من كل رقاقة تصنيع.
التصميم متعدد الشرائح Chiplet
Chiplet هو قالب صغير متخصص. يمكن جمع عدة Chiplets في حزمة واحدة:
- Chiplets للأنوية.
- Chiplet للإدخال والإخراج I/O.
- Chiplet للرسوميات.
- Chiplet للـ Cache.
- Chiplet للذاكرة أو المسرعات.
تستخدم AMD استراتيجية Chiplets في عائلة Zen لفصل مسارات تطوير الأنوية عن I/O، وإضافة Chiplets بحسب عدد الأنوية ومستوى المنتج [7].
فوائد Chiplets
- قابلية التوسع: إضافة Chiplets لرفع عدد الأنوية.
- خفض التكلفة: تصنيع القوالب الصغيرة يرفع نسبة النجاح مقارنة بقالب ضخم.
- مزج تقنيات تصنيع مختلفة: أنوية على عقدة متقدمة وI/O على عقدة أنضج وأقل تكلفة.
- إعادة استخدام التصميم: استخدام Chiplet نفسه في منتجات متعددة.
- مرونة التخصيص: بناء حزم مختلفة للسيرفر والكمبيوتر واللابتوب.
تحديات Chiplets
- زمن الوصول بين الشرائح قد يكون أعلى من الاتصال داخل قالب واحد.
- تحتاج واجهات اتصال عالية السرعة وكفاءة.
- توزيع الطاقة والحرارة أكثر تعقيداً.
- البرمجيات وجدولة الخيوط يجب أن تفهم طوبولوجيا الكاش والذاكرة.
- التغليف والاختبار يصبحان جزءاً أساسياً من التصميم.
2.5D و3D Packaging
في التغليف ثنائي الأبعاد أو 2.5D توضع القوالب جنباً إلى جنب فوق وسيط أو ركيزة عالية الكثافة. في التكديس ثلاثي الأبعاد توضع طبقة فوق أخرى. توضح TSMC أن تقنيات 3DFabric تجمع حلولاً للتكديس ثلاثي الأبعاد والتغليف المتقدم ودمج Chiplets المتجانسة وغير المتجانسة لتحقيق كثافة وأداء وكفاءة أعلى [8].
لم يعد التغليف مرحلة ثانوية بعد تصميم الشريحة؛ أصبح جزءاً من المعمارية نفسها، لأنه يؤثر في عرض النطاق وزمن الوصول والطاقة والتكلفة.
الذاكرة والاتصال: المعركة التي تتجاوز نواة CPU
قد يكون CPU سريعاً، لكنه لن يستفيد من سرعته إذا انتظر البيانات. لذلك يعد Memory Hierarchy من أهم أجزاء المعالج:
- سجلات داخل النواة.
- L1 Cache.
- L2 Cache.
- L3 Cache أو Cache مشتركة.
- RAM.
- SSD أو HDD.
كلما نزلنا في القائمة زادت السعة وانخفضت الكلفة لكل بت، لكن زاد زمن الوصول.
Memory Bandwidth
عرض النطاق هو كمية البيانات التي يمكن نقلها في الثانية. تحتاج GPU وNPU والألعاب وتحرير الفيديو عرض نطاق مرتفعاً، خصوصاً عند مشاركة RAM. لكن عرض النطاق ليس كل شيء؛ زمن الوصول ونمط الوصول والكاش مهمون أيضاً.
Memory Latency
زمن الوصول هو الوقت قبل وصول البيانات. قد تملك ذاكرة ذات عرض نطاق كبير لكنها لا تفيد كثيراً في برنامج يعتمد على طلبات صغيرة متفرقة وزمن وصول منخفض.
Interconnect
Interconnect هو الرابط بين الأنوية والكاش والـ I/O والذاكرة وChiplets. في المعالجات الكبيرة، جودة هذا الرابط قد تحدد الأداء أكثر من زيادة عدد الأنوية. ومن أمثلته روابط داخلية خاصة بكل شركة، وPCIe للاتصال بالمكونات الخارجية.
Coherency
عندما تملك عدة أنوية Cache خاصة، يجب أن تعرف كل نواة ما إذا كانت نسخة البيانات قد تغيرت في نواة أخرى. بروتوكولات Cache Coherence تحافظ على اتساق النسخ، لكنها تستهلك حركة وطاقة وقد تصبح أكثر تعقيداً مع ازدياد الأنوية.
الطاقة والتبريد: لماذا لا تعمل كل الأنوية بأقصى سرعة دائماً؟
كل ترانزستور نشط يستهلك طاقة، وتتحول أجزاء كبيرة منها إلى حرارة. يمكن تبسيط الطاقة الديناميكية تقريباً بالعلاقة:
الطاقة تتأثر بالسعة الكهربائية، وبالتردد، وبمربع الجهد تقريباً.
لذلك قد يؤدي خفض الجهد قليلاً إلى تأثير كبير في الطاقة والحرارة، لكنه قد يجعل الدائرة غير مستقرة إذا انخفض أكثر من اللازم.
Power Gating
إيقاف الطاقة عن أجزاء غير مستخدمة من الشريحة. يساعد في وضع السكون والأحمال الخفيفة.
Clock Gating
إيقاف إشارة الساعة عن وحدة لا تحتاج إلى العمل، لتقليل التبديل واستهلاك الطاقة.
DVFS
Dynamic Voltage and Frequency Scaling، أي تعديل الجهد والتردد ديناميكياً بحسب الحمل والطاقة والحرارة.
Thermal Throttling
إذا وصلت الشريحة إلى حد حراري، تخفض التردد أو الجهد أو توقف أجزاء معينة لحماية نفسها. لذلك قد ترى نتيجة Benchmark قصيرة ممتازة، ثم ينخفض الأداء في اختبار طويل. لمعرفة أسباب ارتفاع حرارة اللابتوب وطرق معالجتها، راجع دليلنا الشامل: لماذا يسخن اللابتوب؟ 17 سبباً خفياً وحلولاً عملية.
Sustained Performance
الأداء المستمر هو ما يستطيع الجهاز الحفاظ عليه بعد دقائق من الحمل، وليس أعلى نتيجة لثوانٍ قليلة. هذه النقطة مهمة جداً عند مقارنة لابتوب نحيف بجهاز ألعاب سميك. إذا لاحظت انخفاضاً في الأداء بعد فترة من الاستخدام، فقد يكون السبب سخونة اللابتوب والخنق الحراري.
وحدات الذكاء الاصطناعي NPU: لماذا أضيفت إلى المعالج؟
تحتاج نماذج الذكاء الاصطناعي إلى ضرب مصفوفات كبيرة وعمليات متكررة. يمكن تنفيذها على CPU، لكن ذلك قد يستهلك طاقة أكثر. GPU مناسب للتوازي، بينما NPU مصمم خصيصاً لنوع من عمليات AI/ML بكفاءة أعلى في سيناريوهات مدعومة.
ماذا تفعل NPU؟
قد تسرع:
- طمس الخلفية في مكالمات الفيديو.
- إزالة الضوضاء من الصوت.
- الترجمة والتفريغ الصوتي.
- تحسين الصور والفيديو.
- تشغيل نماذج لغوية أو بصرية صغيرة محلياً.
- اكتشاف الوجه أو الأشياء.
- بعض ميزات النظام الذكية.
TOPS ليست كل شيء
قد ترى رقماً مثل 40 TOPS أو 45 TOPS. TOPS تعني تريليون عملية في الثانية، لكنها لا تصف وحدها:
- دقة الأرقام المستخدمة INT8 أو FP16.
- نوع العملية.
- كفاءة الذاكرة.
- أداء النموذج الحقيقي.
- دعم البرنامج والواجهة.
- استهلاك الطاقة والحرارة.
لذلك لا تقارن NPU من خلال TOPS فقط. تحقق من التطبيقات التي تدعمها، ومن أداء النموذج الذي يهمك.
CPU وGPU وNPU معاً
أفضل تصميم لا يجعل NPU بديلاً عن CPU. يمكن أن يدير CPU التطبيق والنظام، ويعالج GPU الرسوميات والمصفوفات الكبيرة، ويشغل NPU مهام AI المتكررة منخفضة الطاقة. هذه هي فكرة Heterogeneous Computing: المعالج المناسب للمهمة المناسبة.
تطور معالجات الكمبيوتر: من التردد إلى النظام المتغاير
المرحلة الأولى: زيادة التردد
في مرحلة المعالجات أحادية النواة، كان رفع التردد وتحسين التعليمات أبرز طريق لزيادة الأداء. لكن التردد الأعلى يعني حرارة وطاقة أكبر، وظهرت حدود لا يمكن تجاوزها بسهولة.
المرحلة الثانية: تعدد الأنوية
بدأت الشركات وضع نواتين ثم أربع وثماني أنوية وأكثر. أصبح التركيز على تقسيم المهام، لكن البرامج لم تكن كلها جاهزة للتوازي، فظل أداء النواة الواحدة مهماً.
المرحلة الثالثة: Cache وIPC والتخصص
بدلاً من رفع التردد فقط، حسنت الشركات التنبؤ والفك والتنفيذ خارج الترتيب والكاش، وأضافت تعليمات متجهية وتشفيراً وتسريعاً للفيديو.
المرحلة الرابعة: SoC والرسوميات المدمجة
دمجت المنصات CPU وGPU ومتحكم الذاكرة والاتصال في شريحة واحدة، خصوصاً في الهواتف واللابتوبات منخفضة الطاقة. أدى ذلك إلى أجهزة أنحف وعمر بطارية أطول، مع تنازلات في الترقية أحياناً.
المرحلة الخامسة: التصميم الهجين
أصبح من العملي استخدام P-cores للأحمال الحساسة وE-cores للأعمال الخلفية والمتوازية. انتقل مفهوم big.LITTLE من الهواتف إلى الكمبيوترات، مع حاجة أكبر إلى جدولة واعية بنوع النواة.
المرحلة السادسة: Chiplets والتغليف المتقدم
لم تعد الشريحة الكبيرة هي الطريق الوحيد. فصلت الشركات الأنوية عن I/O، وبدأت تدمج قوالب متعددة، ثم أضافت التكديس ثلاثي الأبعاد للذاكرة أو Cache.
المرحلة السابعة: الحوسبة المتغايرة والذكاء الاصطناعي
أصبح المعالج جزءاً من منصة تحتوي CPU وGPU وNPU ومحركات فيديو وتشفير واتصال، ويقرر البرنامج أو النظام أي وحدة تستخدم لكل مهمة.
مقارنة الاتجاهات الكبرى: Intel وAMD وArm وApple وQualcomm
Intel: الهجين والجدولة
توسعت Intel في تصميم Performance Hybrid الذي يجمع P-cores وE-cores. يرسل Thread Director معلومات إلى نظام التشغيل عن خصائص الخيوط واختلاف الأداء والكفاءة، كي تساعد الجدولة في اختيار النواة المناسبة [4].
AMD: Zen وChiplets وCache
تستخدم AMD معمارية Zen كأساس لعائلات Ryzen وEPYC وThreadripper، وتبرز في استراتيجية Chiplets وفصل الأنوية عن I/O، مع تقنيات Cache مثل 3D V-Cache في منتجات محددة [2] [7].
Arm: الكفاءة والتصميم المرن
Arm تصمم ISA وIP للأنوية والمنصات، وتتبنى فلسفة big.LITTLE وDynamIQ لدمج أنواع مختلفة من الأنوية داخل SoC وإدارة الأداء والطاقة وفق الحمل [3].
Apple Silicon: تكامل SoC والذاكرة الموحدة
تجمع شرائح Apple Silicon بين أنوية أداء وكفاءة وGPU وNeural Engine ومحركات وسائط وذاكرة موحدة داخل تصميم متكامل. هذا يقلل النسخ بين الوحدات، لكنه يعني أن اختيار سعة الذاكرة عند الشراء مهم لأن الذاكرة غالباً جزء من الحزمة وغير قابلة للترقية [6].
Qualcomm Oryon: معالج Arm للمنصات المتنوعة
تصف Qualcomm Oryon بأنه CPU مخصص 64-bit قابل للتوسع، مع تصميم يركز على التنبؤ بالفروع وPrefetching وCache، وفئات Prime وPerformance للموازنة بين الاستجابة والكفاءة داخل منصات تشمل أجهزة الكمبيوتر والهواتف والسيارات [5].
RISC-V: ISA مفتوحة واتجاه قابل للتخصيص
RISC-V ليست شركة معالج بعينها، بل ISA مفتوحة يمكن بناء أنوية مختلفة حولها. ميزتها الأساسية المرونة وإمكان التخصيص، لكن نجاح أي منتج يعتمد على جودة النواة، والمنظومة البرمجية، والأدوات، والتعريفات، والتوافق.
ما معنى «عقدة التصنيع» 3nm أو 5nm؟
تشير عقدة التصنيع إلى جيل من تقنيات تصنيع أشباه الموصلات. تاريخياً كانت الأرقام ترتبط بأبعاد محددة، لكن في العصر الحديث أصبحت تسمية تجارية وتقنية معقدة، ولا يصح مقارنة 3nm من شركة بـ 3nm من شركة أخرى كأنهما الشيء نفسه.
العقدة الأصغر قد تسمح بـ:
- ترانزستورات أكثر في المساحة نفسها.
- استهلاك أقل عند الأداء نفسه.
- أداء أعلى ضمن ميزانية الطاقة نفسها.
- مساحة أكبر لإضافة Cache أو NPU.
لكن الفائدة النهائية تعتمد على المكتبة المنطقية، والتصميم، والتسرب، والتردد، والتغليف، وجودة المنتج، والتبريد. معالج بتصميم أفضل على عقدة أقدم قد يتفوق على تصميم أضعف على عقدة أحدث.
كيف تختار معالج الكمبيوتر أو اللابتوب؟
للدراسة وتصفح الويب
ركز على:
- أداء جيد أحادي الخيط.
- 4 إلى 8 أنوية حديثة بحسب الميزانية.
- ذاكرة 16GB إن أمكن.
- SSD سريع.
- استهلاك منخفض وعمر بطارية مناسب.
للبرمجة
يعتمد الاختيار على نوع التطوير:
- محرر وويب: نواة حديثة وذاكرة كافية.
- مشاريع كبيرة وتجميع متكرر: أنوية أكثر وأداء متعدد الخيوط.
- آلات افتراضية وContainers: RAM كبيرة وعدد أنوية مرتفع.
- تطوير AI محلي: GPU أو NPU مدعوم وذاكرة كافية، لا CPU وحده.
للألعاب
ركز على:
- أداء أحادي الخيط وزمن استجابة منخفض.
- GPU مناسب قبل المبالغة في CPU.
- Cache مفيدة في الألعاب المدعومة.
- تبريد مستمر وTGP واضح في اللابتوب، وتأكد من عدم تعرض الجهاز للسخونة المفرطة أثناء اللعب.
- شاشة بمعدل تحديث يناسب FPS المتوقع.
لتحرير الفيديو والتصميم
ابحث عن:
- أداء متعدد الخيوط.
- GPU يدعم تسريع التطبيق.
- محرك فيديو Hardware Encoder/Decoder مناسب للترميز.
- RAM كبيرة وسريعة.
- SSD سريع ومساحة كافية للملفات المؤقتة.
- شاشة ذات ألوان دقيقة إذا كان العمل احترافياً.
للذكاء الاصطناعي المحلي
تحقق من:
- دعم GPU أو NPU لنوع النموذج.
- حجم VRAM أو Unified Memory.
- دعم CUDA أو Metal أو DirectML أو واجهة مناسبة.
- نوع الدقة INT8/FP16 وغيرها.
- حجم النموذج والذاكرة المطلوبة.
- دعم البرنامج، لأن وجود NPU بلا تطبيق يدعمه لا يقدم فائدة عملية.
للخوادم ومحطات العمل
الأولوية قد تكون لـ:
- عدد الأنوية والخيوط.
- سعة الذاكرة وعدد قنواتها.
- ECC.
- PCIe lanes.
- استمرارية الأداء.
- الاعتمادية والإدارة عن بعد.
- عرض نطاق الذاكرة والاتصال بين Chiplets والمقابس.
كيف تقرأ اسم المعالج؟
تتكون أسماء المعالجات غالباً من:
- العلامة التجارية: Intel Core، AMD Ryzen، Apple M، Qualcomm Snapdragon.
- الفئة: Core Ultra 5، Ryzen 7، M Pro، Snapdragon X Elite.
- رقم الجيل أو الطراز: يحدد العائلة والخصائص، لكنه ليس مقياس أداء مستقلاً.
- اللاحقة: قد تشير إلى الطاقة أو الرسوميات أو قابلية كسر السرعة أو فئة الجهاز.
أمثلة عامة:
- لاحقة
Uغالباً تشير إلى فئة منخفضة الطاقة في بعض عائلات اللابتوب. - لاحقة
HأوHXغالباً تشير إلى فئة أداء أعلى وطاقة أكبر، لكن التفاصيل تختلف حسب الجيل. - لاحقة
Kفي بعض معالجات Intel تشير إلى معامل مفتوح لكسر السرعة، خصوصاً في منصات تدعم ذلك. - أسماء Apple وQualcomm لا تُقرأ بالطريقة نفسها، لذلك قارن داخل العائلة والطراز والاستخدام.
قاعدة: لا تقارن
Core i7أوRyzen 7أوUltra 7دون معرفة الجيل والطراز الكامل وحدود الطاقة والجهاز الذي يركب فيه المعالج.
كيف تختبر أداء المعالج دون الوقوع في فخ الأرقام؟
استخدم اختباراً قريباً من عملك
- اختبار تجميع كود إذا كنت مطوراً.
- اختبار تصيير أو ترميز إذا كنت تعمل بالفيديو.
- اختبار ألعاب بدقة ومعدل إطارات مناسبين إذا كنت لاعباً.
- اختبار نماذج AI إذا كان هدفك تشغيلها محلياً.
ميّز بين Single-Core وMulti-Core
نتيجة Multi-Core العالية قد لا تفيد برنامجاً يستخدم نواة واحدة. ونتيجة Single-Core الممتازة لا تعني أن الجهاز الأفضل للرندر الطويل.
راقب الأداء المستمر
اختبر 10 أو 20 دقيقة لا 30 ثانية فقط، وراقب الحرارة والتردد والطاقة. بعض اللابتوبات ترفع الأداء مؤقتاً ثم تخفضه بسبب التبريد. لمعرفة المزيد عن أسباب هذا السلوك، راجع مقال سخونة اللابتوب.
لا تقارن أنظمة مختلفة دون فهم القياس
قد تختلف المكتبات والمترجمات والتعريفات ونظام التشغيل ودقة الاختبار. الرقم الذي نشرته الشركة قد يكون في أفضل سيناريو، وليس ضماناً لكل جهاز.
راقب استهلاك الطاقة لكل أداء
Performance per Watt مهم في اللابتوب ومراكز البيانات. قد يكون معالج أبطأ قليلاً في أقصى أداء لكنه أفضل بكثير في البطارية والحرارة والضجيج.
نصيحة عملية: أثناء الاختبار، استخدم اختصارات الكيبورد لفتح Task Manager ومراقبة الأداء بسرعة — اختصار
Ctrl + Shift + Escيفتحه فوراً، وWin + Shift + Sلأخذ لقطة شاشة للنتائج.
أخطاء شائعة في فهم المعالجات
«GHz الأعلى يعني المعالج الأسرع دائماً»
خطأ. قارن المعمارية والجيل وIPC والكاش وعدد الأنوية والطاقة. التردد داخل العائلة نفسها مفيد، لكنه ليس قاعدة مطلقة بين أجيال مختلفة.
«عدد الأنوية الأعلى أفضل في كل شيء»
خطأ. إذا كان البرنامج أحادي الخيط أو ضعيف التوازي، قد يفيدك معالج أقل أنوية لكنه أقوى لكل نواة.
«كل الخيوط تساوي أنوية»
خطأ. SMT يزيد الاستفادة من النواة، لكنه لا يضاعف الموارد الفيزيائية بالكامل.
«TDP هو استهلاك المعالج الأقصى»
ليس بالضرورة. هو مؤشر تصميم، وقد تستخدم الشركات حدوداً مختلفة قصيرة أو طويلة المدى.
«3nm أسرع من 5nm في كل حالة»
ليس تلقائياً. عقد التصنيع ليست قابلة للمقارنة البسيطة بين الشركات، والتصميم والطاقة والتبريد عوامل حاسمة.
«NPU يجعل كل برامج الذكاء الاصطناعي أسرع»
لا. يجب أن يدعم التطبيق والمكتبة النموذج والـNPU، وقد يكون GPU أو CPU أفضل لبعض الأحمال.
«SoC أقوى دائماً لأنه يضم كل شيء»
SoC يوفر تكاملاً وكفاءة، لكنه قد يحد الترقية أو مشاركة الذاكرة أو التوسع مقارنة بجهاز مكتبي منفصل.
«المعالج نفسه يقدم الأداء نفسه في كل الأجهزة»
في اللابتوبات خصوصاً، حدود الطاقة والتبريد والـFirmware قد تغير الأداء كثيراً. راجع دليل السخونة لفهم الفرق بين الأداء الأقصى والأداء المستمر.
«Cache أكبر يعني أداء أعلى دائماً»
الفائدة تعتمد على نمط البيانات والبرنامج وزمن الوصول وطريقة مشاركة Cache.
إلى أين تتجه معمارية المعالجات؟
1. مزيد من التغاير
ستستمر الشرائح في دمج P-cores وE-cores وLP-cores وGPU وNPU ومحركات وسائط، مع جدولة أدق للمهمة المناسبة على الوحدة المناسبة.
2. Chiplets أكثر تخصصاً
قد تتكون الحزمة من Chiplet للأنوية، وآخر للـI/O، وآخر للرسوميات، وآخر للذاكرة أو AI. سيسمح ذلك بتخصيص المنتج وتسريع إعادة استخدام التصميم، لكن سيزيد أهمية التغليف والاتصال.
3. Cache وتكديس ثلاثي الأبعاد
سيصبح تقريب البيانات من الأنوية مهماً أكثر، خصوصاً مع اتساع فجوة السرعة بين الحساب والذاكرة. ستتنافس الشركات في Cache المكدسة وذاكرة النطاق العالي وتخفيض زمن الوصول.
4. الذاكرة كجزء من المعمارية
ستزداد أهمية Unified Memory وHBM وCXL وتقنيات مشاركة الذاكرة. لن يكون السؤال «كم عدد الأنوية؟» فقط، بل «كيف تصل هذه الأنوية إلى البيانات؟»
5. الذكاء الاصطناعي على الجهاز
ستنتقل مهام AI من السحابة فقط إلى اللابتوب والهاتف والسيارة، ما يزيد أهمية NPU والذاكرة وكفاءة تشغيل النماذج والخصوصية.
6. أمن مدمج في العتاد
ستزداد وحدات Root of Trust وSecure Boot والتشفير ومراقبة سلامة النظام، مع محاولة تحقيق حماية أعلى دون خفض كبير للأداء.
7. كفاءة الطاقة بدلاً من الأداء الخام فقط
ستصبح مدة البطارية ودرجة الحرارة والضجيج والأداء المستمر معايير مساوية للأداء الأقصى، خصوصاً في أجهزة اللابتوب ومراكز البيانات.
8. تقارب الكمبيوتر والهاتف والسيارة والخادم
قد تستخدم المعمارية الأساسية نفسها في أسواق مختلفة، لكن مع عدد أنوية وGPU وNPU وذاكرة وتبريد مختلف. هذا يرفع قابلية إعادة الاستخدام ويزيد أهمية البرمجيات الموحدة.
قاموس سريع لأهم مصطلحات المعالجات
| المصطلح | المعنى المختصر |
|---|---|
| CPU | وحدة المعالجة المركزية. |
| GPU | معالج الرسوميات والحساب المتوازي. |
| NPU | معالج متخصص في الذكاء الاصطناعي. |
| ISA | مجموعة التعليمات التي يفهمها المعالج. |
| Microarchitecture | التصميم الداخلي لتنفيذ ISA. |
| Core | نواة معالجة فعلية. |
| Thread | مسار تنفيذ برمجي. |
| SMT | تشغيل عدة خيوط على نواة واحدة. |
| IPC | التعليمات المنفذة في الدورة. |
| GHz | مليارات دورات الساعة في الثانية. |
| Turbo/Boost | تردد مرتفع مؤقتاً عند توفر الشروط. |
| Cache | ذاكرة سريعة قريبة من النواة. |
| L1/L2/L3 | مستويات Cache بسرعات وسعات مختلفة. |
| Pipeline | مراحل متداخلة لتنفيذ التعليمات. |
| Out-of-Order | تنفيذ التعليمات المستقلة خارج ترتيبها الظاهر. |
| Branch Prediction | توقع مسار الفروع الشرطية. |
| SIMD | تنفيذ عملية واحدة على عدة بيانات. |
| SoC | نظام متكامل على شريحة. |
| P-core | نواة أداء. |
| E-core | نواة كفاءة. |
| Heterogeneous Computing | توزيع العمل على وحدات مختلفة. |
| Chiplet | قالب صغير يجمع مع قوالب أخرى في حزمة. |
| Monolithic Die | قالب سيليكون واحد كبير. |
| 3D Stacking | تكديس قوالب أو Cache عمودياً. |
| TDP | مؤشر تصميم حراري/طاقي. |
| DVFS | تعديل الجهد والتردد ديناميكياً. |
| Thermal Throttling | خفض الأداء بسبب الحرارة. |
| Unified Memory | ذاكرة مشتركة لوحدات SoC. |
| VRAM | ذاكرة الرسوميات. |
| TOPS | تريليون عملية في الثانية لمسرع AI حسب تعريف القياس. |
| PCIe | ناقل عالي السرعة للمكونات. |
| Memory Bandwidth | كمية البيانات المنقولة في الثانية. |
| Latency | زمن الوصول أو الاستجابة. |
| Benchmark | اختبار معياري للأداء. |
| Performance per Watt | الأداء مقابل استهلاك الطاقة. |
الخلاصة: المعالج الحديث ليس رقماً واحداً
تطورت معالجات الكمبيوتر من نواة واحدة ترفع ترددها إلى أنظمة متغايرة تحتوي أنوية متعددة وأنواعاً مختلفة من وحدات المعالجة، وCache واسعة، وSoC متكاملة، وChiplets، وذاكرة موحدة، وNPU للذكاء الاصطناعي، وتغليف ثلاثي الأبعاد.
التحول الأهم ليس أن المعالج أصبح «أسرع» فقط، بل أن التصميم كله أصبح أكثر تخصصاً وتكاملاً. اليوم قد تنفذ المهمة على P-core، ثم تنتقل مهمة أخرى إلى E-core، وتعالج الصورة على GPU، وتنفذ إزالة الضوضاء على NPU، ويقرأ الجميع من Cache أو ذاكرة مشتركة، بينما يراقب نظام التشغيل الحرارة والطاقة وجدولة الخيوط.
لذلك، عند اختيار معالج، لا تسأل فقط: «كم GHz؟» أو «كم نواة؟». اسأل:
- ما المعمارية والجيل؟
- ما أداء النواة الواحدة والمتعدد؟
- ما حجم Cache وزمن الوصول؟
- ما حدود الطاقة والتبريد في هذا الجهاز؟
- هل الأنوية متجانسة أم هجينة؟
- هل توجد GPU أو NPU مفيدة لبرامجي؟
- هل الذاكرة قابلة للترقية أم موحدة وملحومة؟
- ما الأداء المستمر، وليس نتيجة الثواني الأولى فقط؟
- هل البرنامج الذي أستخدمه يستفيد من هذه الوحدات؟
إذا أجبت عن هذه الأسئلة، ستنتقل من قراءة أسماء تسويقية إلى فهم حقيقي لمعمارية الهاردوير واختيار المعالج المناسب لاحتياجاتك.
اقرأ أيضاً على barqal
- لماذا يسخن اللابتوب؟ 17 سبباً خفياً وحلولاً عملية — دليل شامل لأسباب السخونة والخنق الحراري والحلول.
- دليل اختصارات الكيبورد واللابتوب الشامل: 250+ اختصاراً — اختصارات تسرّع عملك اليومي وتفتح أدوات التشخيص فوراً.
- Why Is Your Laptop Overheating? 17 Hidden Causes and Fixes — English version for bilingual readers.
- The Ultimate Keyboard Shortcuts Guide: 250+ Shortcuts — English shortcut reference.
المراجع
- CPU Clock Speed, Turbo Frequency, and Performance — Intel
- AMD 3D V-Cache Technology — AMD
- Arm big.LITTLE: Processing Architecture for Power Efficiency and Performance — Arm
- Intel Performance Hybrid Architecture and Thread Director — Intel
- Qualcomm Oryon CPU Architecture — Qualcomm
- Apple Silicon, Unified Memory, CPU, GPU, and Neural Engine — Apple
- AMD Zen Core Architecture and Chiplet Design — AMD
- 3DFabric: 3D Silicon Stacking and Advanced Packaging — TSMC